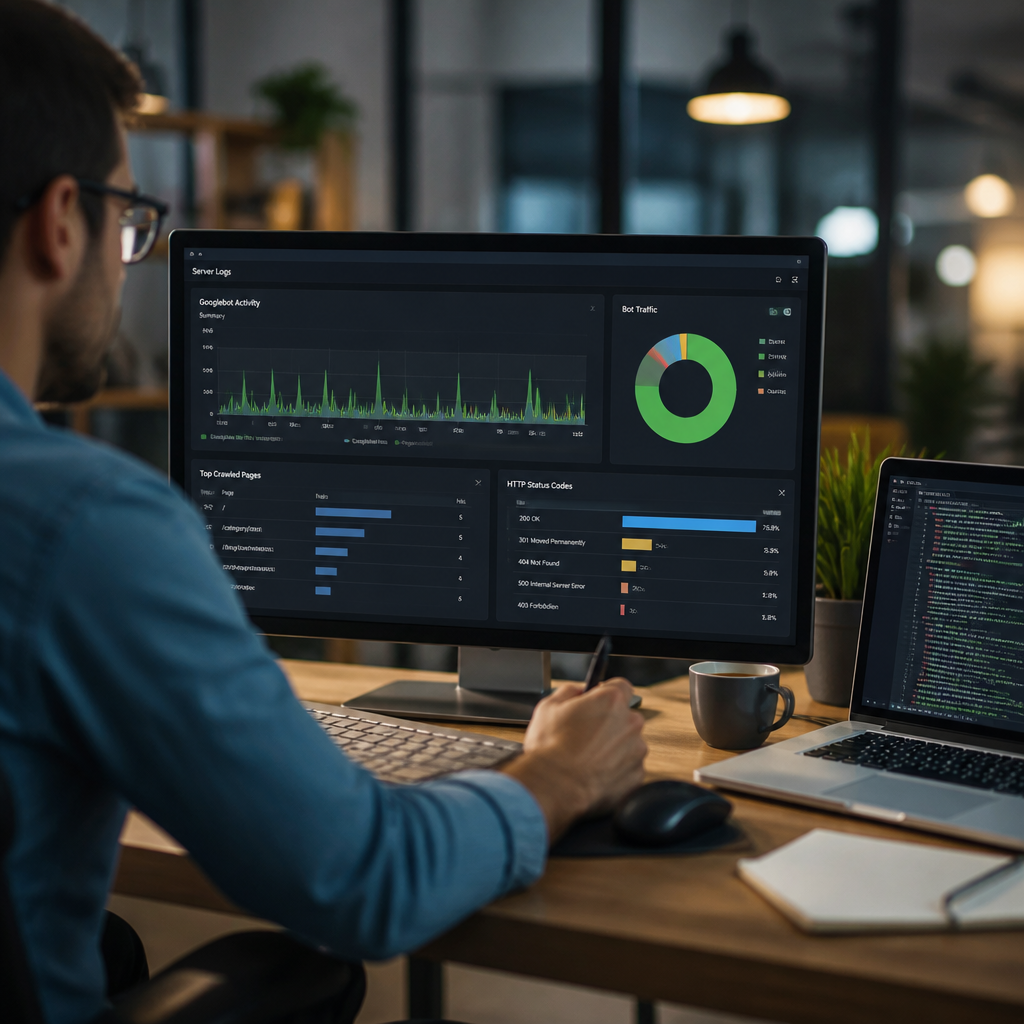
Les fichiers enregistrés par un hébergement web constituent une source précieuse pour comprendre la manière dont les robots des moteurs explorent un site. Ils montrent les requêtes réellement effectuées, les pages consultées, les réponses reçues et la fréquence des visites. Cette vision terrain permet d’aller au-delà des rapports habituels et d’identifier le comportement concret de Googlebot sur chaque section importante.
Bien exploités, ces relevés techniques aident à détecter des pages ignorées, des erreurs répétées ou un gaspillage de ressources sur des URL sans intérêt. L’objectif n’est pas de suivre chaque requête une par une, mais de transformer un grand volume de données en décisions utiles pour améliorer l’exploration et l’indexation de votre site.
Pourquoi examiner les journaux de votre serveur ?
Les outils de suivi classiques indiquent souvent quelles pages reçoivent des visiteurs humains. Les journaux d’accès, eux, révèlent ce que voit le robot du moteur de recherche. Chaque ligne peut contenir une date, une adresse IP, une URL demandée, un code de réponse, un volume de données transmis et parfois l’agent utilisateur. Ces éléments permettent de reconstituer le parcours d’exploration du robot.
Cette lecture est particulièrement utile pour les sites volumineux, les boutiques en ligne, les médias ou les plateformes disposant de nombreux filtres et paramètres d’URL. Sur ces environnements, une mauvaise architecture peut conduire Googlebot à consulter des milliers de pages secondaires tout en délaissant des contenus stratégiques. Les données du serveur apportent alors une preuve directe des priorités de crawl.
Il faut toutefois distinguer un robot revendiqué de Googlebot d’un véritable robot Google. L’agent utilisateur peut être imité par des acteurs malveillants ou des outils automatisés. La vérification passe donc par l’adresse IP et sa résolution de domaine, puis par une confirmation cohérente avec les domaines officiels de Google. Cette étape protège votre étude contre des données faussées par de faux robots.
Les données à isoler avant toute interprétation
Un fichier brut devient rapidement difficile à lire. La première étape consiste à filtrer les requêtes attribuées au robot Google authentifié, puis à regrouper les URL selon leur type : fiches produit, catégories, articles, pages de pagination, fichiers image ou adresses comportant des paramètres. Cette organisation fait ressortir les zones réellement explorées et celles qui restent invisibles.
Conservez les informations essentielles : date et heure, URL demandée, méthode, code HTTP, taille de la réponse, référent éventuel et fréquence des visites. Croisées avec votre plan de site XML et vos données d’indexation, elles permettent de repérer les écarts entre la structure souhaitée et la réalité observée côté serveur.
Les codes HTTP à surveiller
Le code renvoyé par le serveur est l’un des indicateurs les plus utiles. Une page en 200 est accessible, mais cela ne garantit pas qu’elle soit indexée. Une redirection 301 peut être saine si elle accompagne une migration maîtrisée, tandis qu’une chaîne de redirections ralentit l’exploration. Les erreurs 404 et 500 méritent une attention prioritaire, car elles créent des impasses pour les robots.
Le tableau suivant aide à hiérarchiser les contrôles les plus fréquents dans un relevé d’accès.
| Code HTTP | Interprétation pour le robot | Action recommandée |
|---|---|---|
| 200 | Contenu accessible | Vérifier la qualité et le maillage interne |
| 301 | Adresse déplacée durablement | Limiter les redirections successives |
| 404 | Page introuvable | Corriger les liens ou rediriger si pertinent |
| 500 | Erreur interne du serveur | Intervenir rapidement auprès de l’équipe technique |
Ce tableau ne remplace pas l’étude des URL concernées. Une erreur isolée peut être sans gravité, alors qu’une répétition quotidienne sur des pages importantes révèle un problème structurel à corriger.
Une question sur cet article ?
Contactez-nousMesurer la fréquence des visites et la profondeur d’exploration
Une page stratégique devrait être consultée régulièrement, sans pour autant monopoliser inutilement les ressources du serveur. Comparez le nombre de requêtes reçues par les pages commerciales, les contenus éditoriaux et les URL techniques. Si les filtres de tri, les pages de recherche interne ou les variantes de paramètres concentrent l’activité, votre budget d’exploration est peut-être consommé par des adresses peu utiles.
La profondeur est également révélatrice. Les contenus accessibles à plusieurs clics de la page d’accueil sont souvent moins explorés que ceux reliés depuis des pages fortes. Lorsque des URL à forte valeur ne reçoivent presque aucune visite du robot, il convient de revoir leur maillage, leur présence dans le plan de site et leur accessibilité. Une structure claire favorise une circulation plus efficace des robots.
Pour aller plus loin sur ce sujet, consultez cet audit des accès des robots sur un site. Il complète utilement l’observation des requêtes en aidant à distinguer les robots utiles des explorateurs indésirables.
Détecter les anomalies qui freinent la visibilité
Les signaux les plus importants ne sont pas toujours les plus spectaculaires. Une baisse soudaine de requêtes sur une rubrique majeure, une hausse d’erreurs 500 ou l’apparition massive d’URL avec paramètres peuvent révéler un incident avant même que le trafic organique ne recule. Il est donc pertinent de comparer les périodes et de suivre les évolutions anormales dans le temps.
- Des pages importantes jamais demandées par Googlebot.
- Des redirections en cascade entre plusieurs URL.
- Des erreurs 404 sollicitées de manière répétée.
- Des paramètres générant de nombreuses variantes presque identiques.
- Des temps de réponse élevés sur les pages les plus explorées.
Lorsqu’une page ne doit pas être affichée dans les résultats, le choix entre blocage technique et directive d’exclusion doit être cohérent avec votre objectif. Le guide sur le choix entre robots.txt et noindex permet de mieux éviter les décisions contradictoires qui compliquent le travail des moteurs.
Mettre en place une méthode d’analyse régulière
Une étude ponctuelle est utile après une refonte ou une chute de visibilité, mais un suivi mensuel apporte davantage de valeur. Commencez par exporter les fichiers d’accès sur une période représentative. Filtrez ensuite les robots vérifiés, regroupez les URL par modèle de page et observez les codes de réponse. Cette méthode progressive facilite la détection des priorités techniques sans se perdre dans les détails.
- Définir les répertoires et modèles de pages à surveiller.
- Identifier les requêtes attribuées à Googlebot authentifié.
- Classer les URL selon leur fréquence et leur code HTTP.
- Comparer les résultats avec les objectifs de visibilité du site.
- Corriger, puis mesurer l’effet des modifications lors du relevé suivant.
Une solution telle que BotLink peut soutenir cette démarche grâce à son approche Bot To Bot, conçue pour faciliter les échanges entre un site et les robots de Google. Associée à une lecture rigoureuse des journaux techniques, cette approche aide à mieux orienter les efforts de référencement naturel et à renforcer la présence des pages qui comptent vraiment.
Transformer les données techniques en décisions SEO
L’intérêt des journaux serveur ne réside pas dans l’accumulation de chiffres. Leur valeur apparaît lorsqu’ils permettent d’agir : réparer une erreur, simplifier une arborescence, retirer des liens inutiles ou renforcer les connexions vers une page prioritaire. Chaque amélioration doit viser une exploration plus pertinente du site, au service de l’indexation et de la visibilité.
En observant régulièrement les requêtes de Googlebot, vous obtenez une lecture objective de votre accessibilité technique. Cette discipline permet d’anticiper les blocages, de limiter le gaspillage d’exploration et de faire évoluer votre architecture avec méthode. Les relevés serveur deviennent alors un véritable outil de pilotage SEO, et non un simple fichier réservé aux équipes techniques.