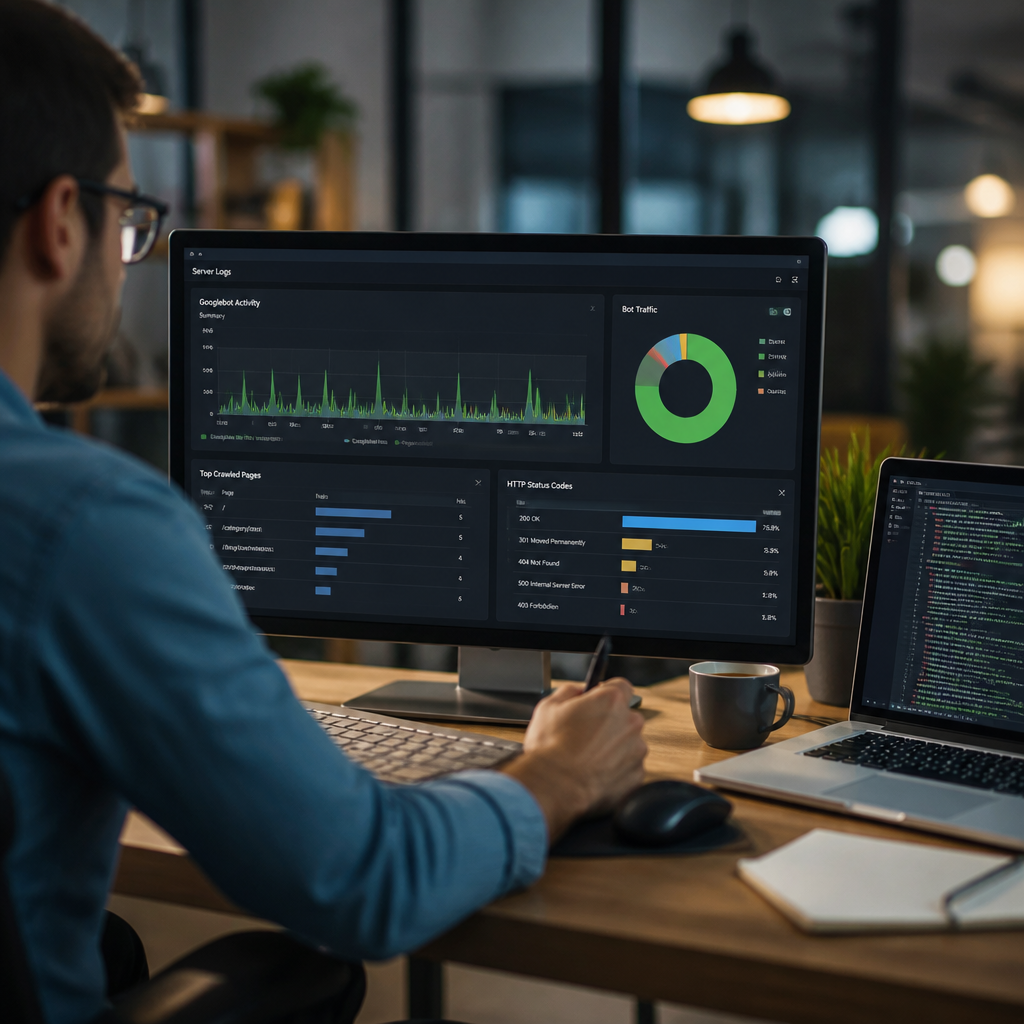
Los archivos registrados por un alojamiento web constituyen una fuente valiosa para comprender la manera en que los robots de los motores exploran un sitio. Muestran las solicitudes realmente efectuadas, las páginas consultadas, las respuestas recibidas y la frecuencia de las visitas. Esta visión sobre el terreno permite ir más allá de los informes habituales e identificar el comportamiento concreto de Googlebot en cada sección importante.
Bien utilizados, estos registros técnicos ayudan a detectar páginas ignoradas, errores repetidos o un desperdicio de recursos en URL sin interés. El objetivo no es seguir cada solicitud una por una, sino transformar un gran volumen de datos en decisiones útiles para mejorar la exploración y la indexación de su sitio.
¿Por qué examinar los registros de su servidor?
Las herramientas de seguimiento clásicas indican a menudo qué páginas reciben visitantes humanos. Los registros de acceso, por su parte, revelan lo que ve el robot del motor de búsqueda. Cada línea puede contener una fecha, una dirección IP, una URL solicitada, un código de respuesta, un volumen de datos transmitido y a veces el agente de usuario. Estos elementos permiten reconstruir el recorrido de exploración del robot.
Esta lectura es particularmente útil para sitios voluminosos, tiendas en línea, medios de comunicación o plataformas que disponen de numerosos filtros y parámetros de URL. En estos entornos, una mala arquitectura puede llevar a Googlebot a consultar miles de páginas secundarias mientras descuida contenidos estratégicos. Los datos del servidor aportan entonces una prueba directa de las prioridades de rastreo.
Sin embargo, es necesario distinguir entre un robot que dice ser Googlebot y un verdadero robot de Google. El agente de usuario puede ser imitado por actores malintencionados o herramientas automatizadas. Por lo tanto, la verificación se realiza mediante la dirección IP y su resolución de dominio, seguida de una confirmación coherente con los dominios oficiales de Google. Este paso protege su estudio contra datos sesgados por robots falsos.
Los datos que deben aislarse antes de cualquier interpretación
Un archivo sin procesar se vuelve difícil de leer rápidamente. El primer paso consiste en filtrar las solicitudes atribuidas al robot de Google autenticado y luego agrupar las URL según su tipo: fichas de producto, categorías, artículos, páginas de paginación, archivos de imagen o direcciones que contengan parámetros. Esta organización pone de relieve las zonas realmente exploradas y aquellas que permanecen invisibles.
Conserve la información esencial: fecha y hora, URL solicitada, método, código HTTP, tamaño de la respuesta, referente eventual y frecuencia de las visitas. Cruzadas con su mapa del sitio XML y sus datos de indexación, permiten detectar las discrepancias entre la estructura deseada y la realidad observada del lado del servidor.
Los códigos HTTP que hay que 【1】vigilar【/1】
El código devuelto por el servidor es uno de los indicadores más útiles. Una página 200 es accesible, pero eso no garantiza que esté indexada. Una redirección 301 puede ser saludable si acompaña a una migración controlada, mientras que una cadena de redirecciones ralentiza la exploración. Los errores 404 y 500 merecen una atención prioritaria, ya que crean callejones sin salida para los robots.
La siguiente tabla ayuda a priorizar los controles más frecuentes en un registro de acceso【1】…【/1】.
| Código HTTP | Interpretación para el robot | Acción recomendada |
|---|---|---|
| 200 | Contenido accesible | Verificar la calidad y el 【1】enlazado interno【/1】 |
| 301 | Dirección movida permanentemente | Limitar las redirecciones sucesivas |
| 404 | Página no encontrada | Corregir los enlaces o redirigir si es pertinente |
| 500 | Error interno del servidor | Intervenir rápidamente con el 【1】equipo técnico【/1】 |
Esta tabla no sustituye el estudio de las URL correspondientes. Un error aislado puede no tener gravedad, mientras que una repetición diaria en páginas importantes revela un problema estructural que debe corregirse.
¿Alguna pregunta sobre este artículo?
: ContáctanosMedir la frecuencia de las visitas y la profundidad de exploración
Una página estratégica debe consultarse regularmente, sin por ello monopolizar innecesariamente los recursos del servidor. Compare el número de solicitudes recibidas por las páginas comerciales, los contenidos editoriales y las URL técnicas. Si los filtros de ordenación, las páginas de búsqueda interna o las variantes de parámetros concentran la actividad, su presupuesto de rastreo podría estar consumido por direcciones poco útiles.
La profundidad también es reveladora. Los contenidos accesibles a varios clics de la página de inicio a menudo se exploran menos que los enlazados desde páginas fuertes. Cuando las URL de alto valor apenas reciben visitas del robot, conviene revisar su enlazado, su presencia en el mapa del sitio y su accesibilidad. Una estructura clara favorece una circulación más eficiente de los robots.
Para profundizar en este tema, consulte esta auditoría de los accesos de los robots a un sitio. Esta complementa eficazmente la observación de las solicitudes al ayudar a distinguir los robots útiles de los rastreadores no deseados.
Detectar las anomalías que frenan la visibilidad
Las señales más importantes no siempre son las más espectaculares. Una caída repentina de las consultas en una sección importante, un aumento de los errores 500 o la aparición masiva de URL con parámetros pueden revelar un incidente incluso antes de que el tráfico orgánico disminuya. Por lo tanto, es pertinente comparar los períodos y realizar un seguimiento de las evoluciones anormales en el tiempo.
- Páginas importantes nunca solicitadas por Googlebot.
- Redirecciones en cascada entre varias URL.
- Errores 404 solicitados de manera repetida.
- Parámetros que generan numerosas variantes casi idénticas.
- Tiempos de respuesta elevados en las páginas más exploradas.
Cuando una página no debe mostrarse en los resultados, la elección entre un bloqueo técnico y una directiva de exclusión debe ser coherente con su objetivo. La guía sobre cómo elegir entre robots.txt y noindex permite evitar mejor las decisiones contradictorias que complican el trabajo de los motores de búsqueda.
Establecer un método de análisis regular
Un estudio puntual es útil después de una renovación o una caída de visibilidad, pero un seguimiento mensual aporta más valor. Comience por exportar los archivos de acceso durante un periodo representativo. Filtre luego los robots verificados, agrupe las URL por modelo de página y observe los códigos de respuesta. Este método progresivo facilita la detección de las prioridades técnicas sin perderse en los detalles.
- Definir los directorios y plantillas de páginas que se deben supervisar.
- Identificar las solicitudes atribuidas a Googlebot autenticado.
- Clasificar las URL según su frecuencia y su código HTTP.
- Comparar los resultados con los objetivos de visibilidad del sitio.
- Corregir y, a continuación, medir el efecto de las modificaciones en el siguiente relevamiento.
Una solución como BotLink puede apoyar este enfoque gracias a su método Bot To Bot, diseñado para facilitar los intercambios entre un sitio y los robots de Google. Combinado con una lectura rigurosa de los registros técnicos, este enfoque ayuda a orientar mejor los esfuerzos de posicionamiento orgánico y a reforzar la presencia de las páginas que realmente importan.
Transformar los datos técnicos en decisiones SEO
El interés de los registros del servidor no reside en la acumulación de cifras. Su valor aparece cuando permiten actuar: reparar un error, simplificar una estructura de árbol, eliminar enlaces inútiles o reforzar las conexiones hacia una página prioritaria. Cada mejora debe apuntar a una exploración más pertinente del sitio, al servicio de la indexación y la visibilidad.
Al observar regularmente las solicitudes de Googlebot, obtiene una lectura objetiva de su accesibilidad técnica. Esta disciplina permite anticipar los bloqueos, limitar el desperdicio de rastreo y hacer evolucionar su arquitectura con método. Los registros del servidor se convierten entonces en una verdadera herramienta de gestión SEO, y no en un simple archivo reservado para los equipos técnicos.