Ocultar una URL de los resultados de búsqueda no consiste solo en hacerla menos visible. Hay que distinguir el control de la indexación del control de la visualización en el índice. Estos dos mecanismos responden a objetivos diferentes, y confundirlos puede dejar una página accesible en los resultados cuando creías haberla eliminado.
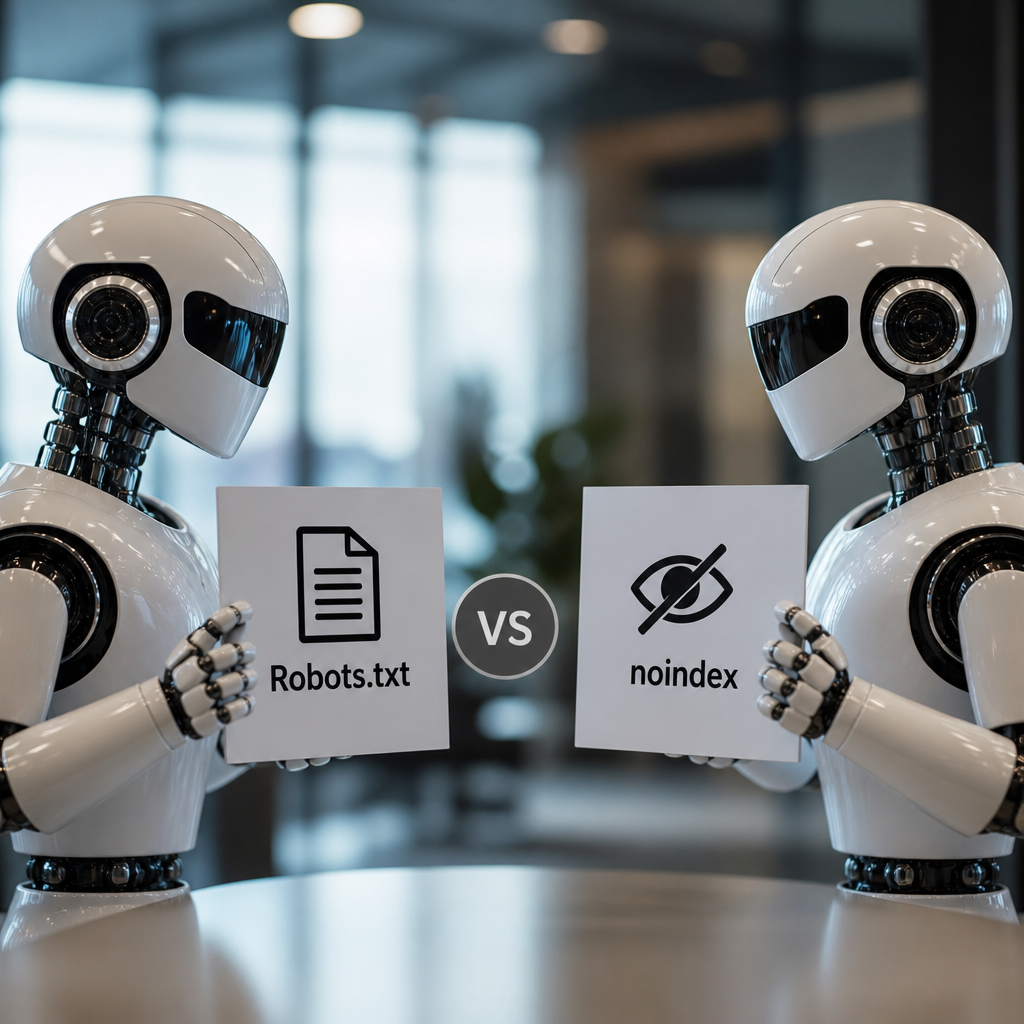
El archivo robots.txt indica a los robots qué áreas del sitio pueden rastrear. La directiva meta con noindex, por su parte, solicita que una página consultable por los robots no se conserve en los resultados. La elección correcta depende, por lo tanto, de su intención real: limitar las solicitudes de los robots, retirar una URL del motor o proteger un contenido sensible.
Comprender la diferencia entre exploración e indexación
La exploración corresponde al paso de los robots por sus URL para leer su contenido. La indexación interviene después: el motor analiza la página y decide, o no, añadirla a su base de resultados. Prohibir el acceso no equivale automáticamente a eliminar una URL del índice. Una dirección puede ser conocida gracias a enlaces externos, a un sitemap o a un análisis anterior.
Este matiz explica un error frecuente: añadir una regla de prohibición en robots.txt para hacer desaparecer una página de los resultados. Si el robot ya no puede cargar la página, no puede leer la instrucción que le pide que no la indexe. La URL puede entonces permanecer visible, a veces sin descripción detallada. Google recomienda dejar que el robot acceda a una página cuando el objetivo es su retirada duradera de los resultados.
¿Cuándo usar el archivo robots.txt?
El archivo robots.txt se coloca en la raíz del dominio y sirve principalmente para organizar el paso de los robots. Es relevante para directorios técnicos, parámetros que generan un gran número de URL, páginas de búsqueda interna o espacios cuyo análisis no aporta ningún valor SEO.
Reducir la exploración de áreas innecesarias
En un sitio de comercio electrónico, por ejemplo, los filtros de color, talla o clasificación pueden generar miles de combinaciones. Impedir que los robots rastreen algunas de estas URL evita malgastar recursos del servidor y ayuda a concentrar el análisis en las páginas estratégicas. Esta lógica concierne a la gestión del recorrido de los robots, y no a la eliminación garantizada de un contenido ya conocido.
El mismo razonamiento se aplica a los calendarios infinitos, las páginas de inicio de sesión, los carritos o los scripts no esenciales. Sin embargo, hay que tener cuidado: una regla demasiado amplia puede impedir el análisis de archivos útiles para la representación de sus páginas. Google recomienda en particular bloquear solo los recursos no críticos para comprender el contenido y la maquetación.
Los límites a conocer
Un archivo robots.txt no es ni una protección de acceso ni una herramienta de privacidad. Su contenido es público y su respeto depende del robot que lo consulta. Por lo tanto, nunca debe utilizarse para proteger documentos internos, datos personales o páginas reservadas a clientes. Para estos contenidos, es preferible una autenticación.
Además, la prohibición de exploración no garantiza que la dirección nunca aparezca en un motor. Si hay enlaces que apuntan a ella, el motor puede mostrar la URL sin haber podido analizar su contenido. Por lo tanto, este método es útil para controlar el rastreo, pero no es la respuesta ideal cuando el objetivo es la desaparición neta de una página de los resultados.
¿Alguna pregunta sobre este artículo?
: Contáctanos¿Cuándo priorizar la directiva meta con noindex?
Para eliminar una página existente de los resultados y al mismo tiempo mantenerla accesible para los visitantes, la solución más adecuada suele ser una instrucción de exclusión colocada en el código de la página. Se encuentra en la sección head del documento HTML e informa a los motores compatibles que no deben conservar esta URL en su índice.
Esta opción es adecuada para páginas de agradecimiento después de un formulario, contenidos de prueba, fichas internas, archivos de poca utilidad, versiones imprimibles o páginas de clasificación. Los internautas que posean el enlace aún podrán consultarlas, pero ya no están destinadas a atraer tráfico orgánico. La página debe seguir siendo accesible para el robot, sin bloqueo en el archivo robots.txt, para que se detecte la instrucción.
El caso de los PDF, imágenes y otros archivos
Una etiqueta meta solo se puede agregar en una página HTML. Para un PDF, una imagen, un video u otro archivo, la solución adecuada es enviar una cabecera HTTP X-Robots-Tag que contenga noindex. Este método extiende el control de indexación a recursos no HTML, sin tener que modificar su contenido.
A menudo solicita la intervención de un desarrollador o una configuración del servidor. Antes de aplicarlo a un conjunto de archivos, verifique el alcance exacto: eliminar un documento útil, una imagen de producto o un recurso descargado puede tener consecuencias en la visibilidad y la experiencia del usuario.
¿Qué método elegir según tu objetivo?
La elección se vuelve simple una vez que la intención está claramente formulada. Utiliza robots.txt cuando quieras evitar peticiones innecesarias en ciertas áreas, especialmente URL dinámicas o técnicas. Utiliza noindex cuando la página deba permanecer disponible, pero ya no deba aparecer en los resultados de búsqueda.
- Para una página privada: implemente acceso con contraseña o elimine el contenido.
- Para una URL eliminada sin equivalente: devuelve un código HTTP 404 o 410.
- Para una página movida con un reemplazo relevante: usa una redirección permanente 301.
- Para contenido accesible pero no destinado a SEO: añade una instrucción noindex y permite su rastreo.
- Para espacios técnicos o filtros sin interés: limite la exploración a través de robots.txt.
Una página eliminada del sitio no debe recibir la misma respuesta que una página simplemente excluida de los resultados. Cada estado responde a una situación comercial diferente. Una redirección mal elegida, como una exclusión aplicada a una página de alto potencial, puede perturbar a los usuarios y reducir el rendimiento orgánico.
Verificar la configuración antes de modificar más
Después de añadir una directiva noindex, la eliminación no siempre es instantánea. El motor necesita volver a visitar la URL, leer la información y luego actualizar su índice. Utiliza la herramienta de inspección de URLs en Search Console para verificar lo que Google recibe realmente. La inspección técnica debe centrarse en la versión rastreada por el robot, no solo en lo que ves en tu navegador.
Analice también el informe de indexación y pruebe sus reglas robots.txt antes de publicarlas. Una auditoría regular de los accesos automatizados permite identificar bloqueos accidentales y URL que consumen innecesariamente el presupuesto de rastreo. El artículo sobre la auditoría de accesos de robots aporta referencias útiles para estructurar esta verificación.
Hacer del enmascaramiento una decisión coherente de SEO
La mejor solución no es la que bloquea más, sino la que se corresponde precisamente con el rol de cada URL. Una arquitectura SEO sana distingue los contenidos a valorar, a explorar y a descartar. Esta lógica evita transformar ajustes técnicos en obstáculos para tu visibilidad.
En una estrategia impulsada por la inteligencia artificial, como el enfoque Bot To Bot propuesto por BotLink, comprender el diálogo entre su sitio y los robots se vuelve esencial. No se trata solo de ocultar páginas, sino de ayudar a los motores a dedicar su atención a los recursos correctos. Para profundizar en este tema, descubra los desafíos de una indexación estratégica.